

📌 Meta nutzt und trainiert seine KI mit deinen Facebook und Instagram-Inhalten
- 📅 Start: 27. Mai 2025
- 🧠 Betroffen: öffentliche Inhalte auf Facebook, Instagram & Co.
- ❌ Private Nachrichten & „Nur Freunde“-Beiträge bleiben außen vor
- 📝 Du kannst widersprechen, aber nur bis 26. Mai!
- ⚠️ Auch Inhalte über dich (z. B. Fotos von anderen) können verwendet werden, trotz Widerspruch
👉 Lies hier, was das bedeutet und wie du dich schützt.
Nutzer:innen fragen, wir antworten
„Bringt der Widerspruch überhaupt etwas, oder ist das reine Beruhigung?“
Ja, er verhindert die Verwendung deiner eigenen öffentlichen Inhalte, nicht aber Inhalte über dich, die andere posten.
„Kann ich prüfen, ob sich Meta an meinen Widerspruch hält?“
Nein, es gibt keine Einsicht oder Garantie, das ist ein Kritikpunkt vieler Datenschützer.
„Muss ich für Instagram, Facebook und WhatsApp getrennt widersprechen?“
Ja. Facebook und Instagram benötigen jeweils ein eigenes Formular. Für WhatsApp ist derzeit kein Widerspruch nötig, da keine KI-Nutzung öffentlich angekündigt wurde.
„Wenn Meta die Richtlinien später ändert, muss ich dann erneut widersprechen?“
Möglicherweise ja, bei jeder relevanten Änderung der Datenschutzrichtlinien.
„Wird Meta auch Posts von anderen über mich verwenden?“
Ja, wenn du z. B. markiert wirst oder jemand öffentlich ein Bild mit dir postet, kann das ins KI-Training einfließen.
„Warum stört es überhaupt, wenn eine KI meine öffentlichen Posts analysiert?“
Weil du keine Kontrolle hast, was daraus gemacht wird, z. B. ob dein Tonfall später in Werbung oder Chatbots nachgebildet wird.
„Ist der Widerspruch nicht sinnlos, wenn man sowieso ständig getrackt wird?“
Nein, es geht nicht um Tracking, sondern um KI-Training. Deine Inhalte helfen Maschinen, menschliches Verhalten zu imitieren. Wer das nicht will, sollte widersprechen.
„Gilt mein Widerspruch dauerhaft, oder muss ich das regelmäßig wiederholen?“
Aktuell gilt der Widerspruch unbefristet für den festgelegten Zweck (KI-Training). Ändert Meta jedoch die Datenschutzrichtlinie oder erweitert den Anwendungsbereich, könnte eine neue Zustimmung (oder ein erneuter Widerspruch) nötig sein. Es empfiehlt sich, die Datenschutzhinweise regelmäßig zu überprüfen.
„Kann ich meine alten Beiträge löschen, um sie aus dem KI-Training rauszuhalten?“
Theoretisch ja, aber: Wenn der Beitrag vor dem 27. Mai öffentlich war und du nicht widersprochen hast, könnten diese Inhalte bereits in KI-Trainingsdaten eingeflossen sein. Eine nachträgliche Löschung verhindert also nicht, dass diese Informationen schon verarbeitet wurden.
Worum geht es?
Meta (Konzern hinter Facebook, Instagram, Threads und WhatsApp) hat angekündigt, öffentliche Inhalte seiner Nutzer*innen in Europa für das Training von Künstlicher Intelligenz zu verwenden. Ab dem 27. Mai 2025 sollen z. B. Facebook-Posts, Instagram-Fotos oder öffentliche Kommentare in die Entwicklung von Meta’s KI-Modellen einfließen. Diese KI-Modelle, dazu zählen Chatbots wie „Meta AI“ und Sprachmodelle der LLaMA-Reihe, lernen aus enormen Datenmengen. Durch die Einbeziehung echter Nutzerbeiträge will Meta seine KI verbessern, damit sie z. B. Europas Sprachen, Umgangston und Kultur besser versteht und widerspiegelt.
Welche Daten werden genutzt?
Wichtig: Es geht nur um Inhalte, die für alle öffentlich sichtbar sind. Dazu zählen öffentliche Posts und Storys, Fotos, Videos, Reels, Kommentare, „Gefällt mir“-Angaben und Ähnliches, egal ob auf dem eigenen Profil oder z. B. in öffentlichen Gruppen. Auch öffentliche Profilinformationen (Name, Nutzername, Profilbild) fallen darunter. Nicht-öffentliche Inhalte hingegen bleiben tabu: Private Chats (etwa in WhatsApp oder Facebook Messenger) sowie Posts, die man nur mit Freunden geteilt hat, werden laut Meta nicht für KI-Zwecke ausgelesen. Ebenso ausgeschlossen sind Daten von Minderjährigen unter 18 in Europa. Meta greift also auf das zurück, „was ohnehin jeder andere im Internet sehen kann“, nicht mehr, aber auch nicht weniger.
Beispiele: Ein öffentliches Instagram-Foto könnte zur Verbesserung von Bild-KI dienen (etwa um realistischere KI-Bilder zu erzeugen), und ein öffentlich geposteter Facebook-Kommentar in deutscher Sprache könnte dazu beitragen, dass Metas Sprachmodell besser Deutsch versteht. Auch Emotionen und Stimmungen will Meta aus Textbeiträgen auslesen lassen, um die KI darauf zu trainieren, positive oder negative Tonlagen zu erkennen. Fotos von Gesichtern könnten die KI befähigen, Gesichtserkennung und Personenerkennungstechnologien zu verfeinern, was Datenschützer allerdings kritisch sehen.
Außerdem fließen Interaktionsdaten mit ein: Wie Nutzer auf Inhalte reagieren, was sie interessiert, wie lange sie etwas anschauen, soll den KI-Algorithmen helfen, personalisierte Inhalte und Empfehlungen zu verbessern. Kurz gesagt, alles, was wir öffentlich auf Meta-Plattformen tun oder sagen, kann der Konzern nun zum „Lernen“ für seine KI nutzen.
Warum macht Meta das?
Meta befindet sich im Wettrennen um generative KI, Konkurrenten wie OpenAI (ChatGPT) oder Google investieren stark in KI-Systeme. Bisher hinkte Meta etwas hinterher, will aber jetzt mit eigenen Angeboten aufholen. Die riesigen Mengen an Facebook- und Instagram-Posts aus fast zwei Jahrzehnten sind ein Schatz an Sprache, Bildern und menschlichem Verhalten. Indem Meta diese ohne direkte Zustimmung der Nutzer auswerten darf, spart es Zeit und Kosten, um seine KI schneller „schlauer“ zu machen.
Offiziell begründet Meta den Schritt damit, dass die KI für europäische Nutzer*innen nützlicher und kulturell passender werden soll, zum Beispiel, indem sie lokale Sprachen/Dialekte besser versteht oder relevantere Antworten und Inhalte liefert. Kritiker vermuten dahinter aber vor allem den Versuch, verlorenen Boden gutzumachen und neue KI-basierte Produkte (Chatbots, Bildgeneratoren, Moderations-Tools etc.) zu entwickeln, die Meta konkurrenzfähig halten.
Darf Meta das einfach so?
Hier kommt der Datenschutz ins Spiel. In Europa gilt: Für die Verarbeitung persönlicher Daten braucht es eine Rechtsgrundlage. Anstatt jeden Einzelnen, um Einwilligung zu bitten, stützt sich Meta auf das Konzept des „berechtigten Interesses“ (Legitimate Interest). Vereinfacht heißt das: Meta meint, ein überwiegendes eigenes Interesse daran zu haben, diese Daten zu nutzen, und hält das für datenschutzrechtlich vertretbar, solange Nutzer*innen widersprechen können, wenn sie nicht einverstanden sind.
Diese Opt-out-Lösung ist umstritten. Datenschützer betonen, dass bei einem berechtigten Interesse stets sorgfältig gegen die Rechte der Betroffenen abgewogen werden muss. Gerade die umfangreiche Nutzung persönlicher Posts, ohne vorher zu fragen, stößt auf Kritik. In einem ähnlichen Fall (personalisierte Werbung) hatte der Europäische Gerichtshof Meta untersagt, sich bloß auf berechtigtes Interesse zu berufen. Ob Metas Vorgehen beim KI-Training legal ist, müssen möglicherweise Gerichte klären.
Aufsichtsbehörden in der EU haben die Pläne vorab geprüft: Die irische Datenschutzbehörde DPC, zuständig für Meta, verlangte Nachbesserungen, etwa transparente Nutzerinformation, einfache Widerspruchsmöglichkeiten und technische Schutzmaßnahmen. Meta hat daraufhin den Start in Europa verschoben (eine frühere Einführung 2024 wurde ausgesetzt) und die Anforderungen umgesetzt. Ende Mai 2025 gab es grünes Licht, zumindest vorläufig: Weder der DPC noch andere EU-Datenschützer haben ein Verbot erlassen.
Ein Eilantrag deutscher Verbraucherschützer, Metas Datenverwendung zu stoppen, blieb vor Gericht erfolglos. Dennoch wird betont, dass die Behörden genau hinschauen werden, wie Meta mit den Daten umgeht. Meta muss z. B. im Oktober 2025 Bericht erstatten, ob die zugesagten Schutzvorkehrungen wirksam sind.
Was können Nutzer*innen jetzt tun?
Wer nicht möchte, dass seine öffentlichen Posts fürs KI-Training verwendet werden, sollte von seinem Widerspruchsrecht Gebrauch machen. Meta hat hierfür eigens Formulare bereitgestellt. In den Facebook-Einstellungen findet sich etwa im Bereich „Privatsphäre“ ein Hinweis „Widerspruch gegen die Verwendung deiner Daten für KI“, der zum Formular führt.
Ähnlich auf Instagram: Unter „Einstellungen und Privatsphäre“ ⟶ „Über“ ⟶ „Datenschutzrichtlinie“ gibt es den Punkt „Recht auf Widerspruch“. Dort trägt man seine E-Mail-Adresse ein und bestätigt den Widerspruch. Wichtig: Der Widerspruch muss pro Plattform separat erfolgen, also z. B. einzeln für Facebook und für Instagram. Wer beide Dienste nutzt, sollte in beiden Accounts das Formular absenden. Meta verschickt anschließend eine Bestätigung per Mail oder Notification.
Bis wann muss man widersprechen?
Die Möglichkeit besteht zwar jederzeit, aber um sicherzugehen, dass auch alle bisherigen Inhalte verschont bleiben, sollte der Widerspruch unbedingt vor dem 27. Mai 2025 bei Meta eingehen. Offiziell beginnt Meta an diesem Tag mit dem KI-Training; Inhalte, die bis dahin öffentlich waren und nicht durch Widerspruch ausgenommen wurden, können dann verarbeitet werden.
📥 Widerspruch einlegen – so geht’s:
Wenn du nicht möchtest, dass Meta deine öffentlichen Inhalte für KI-Training verwendet, kannst du hier widersprechen:
🔗 Facebook-Widerspruchsformular:
https://www.facebook.com/help/contact/712876720715583
🔗 Instagram-Widerspruchsformular:
https://help.instagram.com/contact/233964459562201
📌 Wichtig:
– Du musst jeweils separat für Facebook und Instagram widersprechen.
– Der Widerspruch muss bis spätestens 26. Mai 2025 eingehen, um auch alte Inhalte auszuschließen.
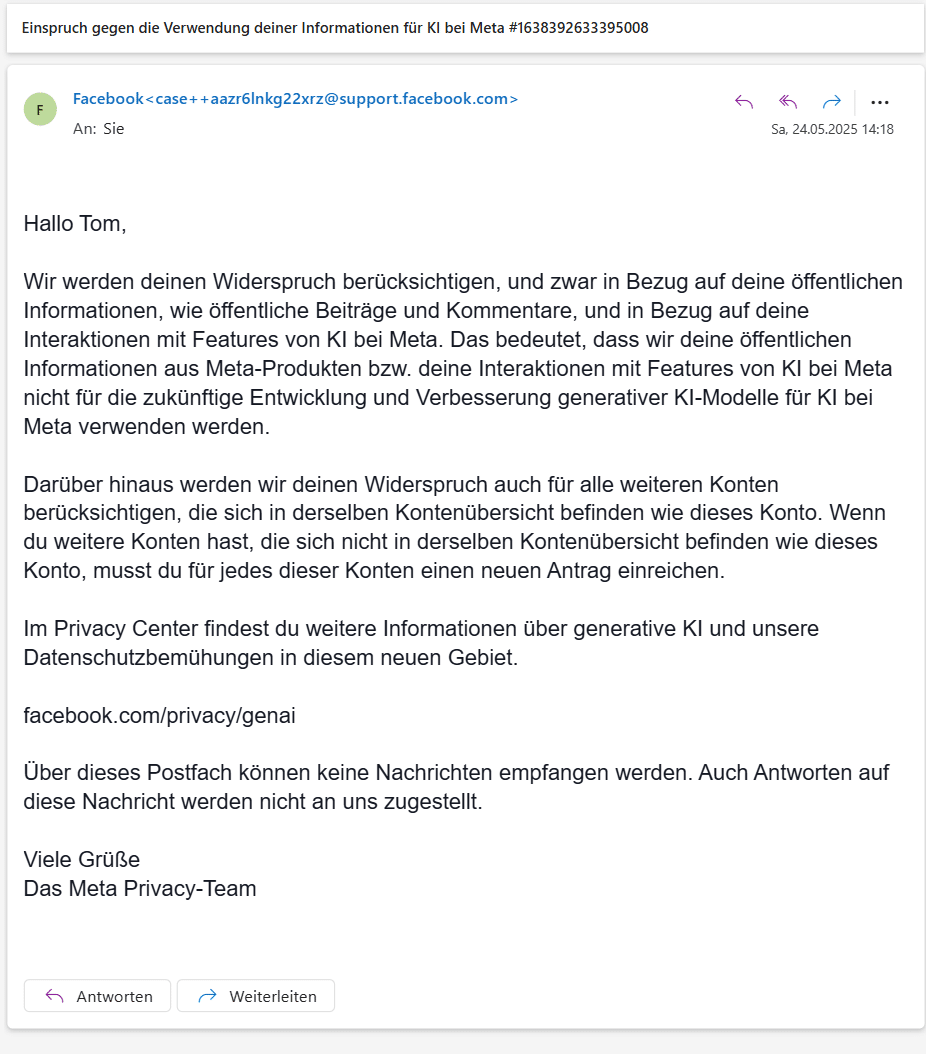
– Du erhältst eine Bestätigung per E-Mail oder In-App-Nachricht.
So sieht die E-Mail aus, die man nach dem Einspruch erhält:
Ein späterer Widerspruch (nach dem Start) stoppt nur die künftige Nutzung, bereits verwendete Daten lassen sich nicht zurückholen. Wir raten: „Jetzt widersprechen oder für immer schweigen“, da einmal in die KI eingeflossene Daten dauerhaft im Modell verbleiben. Es geht hier vor allem um Prävention: Lieber vorsichtshalber widersprechen, auch wenn man aktuell kaum öffentliche Inhalte hat, denn was einmal in der KI gelandet ist, kann später nicht mehr einzeln gelöscht werden.
Fazit:
Meta’s Plan, unsere öffentlich geteilten Facebook-, Instagram- und Threads-Inhalte zum Training von KI zu nutzen, sorgt verständlicherweise für Unruhe, aber Panik ist nicht angebracht. Wichtig ist, die Fakten zu kennen: Private Daten bleiben außen vor, und es besteht ein Widerspruchsrecht, von dem man relativ unkompliziert Gebrauch machen kann. Wer Wert auf Datenschutz legt oder einfach nicht möchte, dass etwa Urlaubsfotos zur „Futtersammlung“ für einen KI-Bot werden, sollte vorsorglich widersprechen (ein Vorgang von wenigen Minuten). Gleichzeitig muss man sich bewusst machen, dass öffentliche Posts im Internet generell von Dritten analysiert werden könnten, sei es von Suchmaschinen, Archiven oder nun eben von KI-Systemen.
Häufig gestellte Fragen und Antworten
Richtig. Meta hat angekündigt, ab diesem Datum in Europa öffentliche Beiträge und Kommentare von Nutzer*innen (ab 18 Jahren) auf Facebook und Instagram (und vergleichbaren Meta-Plattformen) zum Training seiner generativen KI-Modelle zu verwenden. Auch die Interaktionen mit dem neuen Meta AI-Chatbot (Fragen, Eingaben usw.) werden mit in die Trainingsdaten einfließen. Anmerkung: Diese Nutzung betrifft nur Inhalte, die ohnehin für alle sichtbar sind, etwa öffentliche Posts, Kommentare in öffentlichen Profilen oder Gruppen etc. Inhalte, die privat geteilt wurden, sind nicht eingeschlossen.
Richtig. Meta beschränkt sich nicht nur auf neue Posts, sondern will auch rückwirkend ältere, bereits veröffentlichte öffentliche Inhalte auswerten. Das schließt z. B. Fotos oder Beiträge ein, die vor 2025 gepostet wurden, solange sie öffentlich zugänglich sind. Mit anderen Worten: 20 Jahre Facebook- und Instagram-Inhalte europäischer Nutzer könnten ins KI-Training fließen. Wer also in der Vergangenheit viel öffentlich gepostet hat, dessen bestehende Inhalte könnten nun verwendet werden.
Richtig. Meta betont ausdrücklich, dass private Chats und nicht-öffentliche Posts nicht fürs KI-Training genutzt werden. Kommunikation mit Freunden/Familie in privaten Messengern bleibt unberührt. Ebenso werden Beiträge von Jugendlichen unter 18 in der EU nicht in die Trainingsdaten aufgenommen. Es geht Meta nur um öffentlich Zugängliches, „was ohnehin jeder sehen kann“. Hinweis: Öffentliche Profilinformationen (z. B. Name, Profilfoto) gelten allerdings immer als öffentlich und könnten daher ebenfalls verwendet werden.
Im Wesentlichen korrekt. Meta informiert EU-Nutzer*innen per In-App-Banner und E-Mail über ein Widerspruchsrecht und stellt ein Online-Formular bereit. Wer bis zum 26. Mai 2025 widerspricht, kann dadurch verhindern, dass seine bis dahin veröffentlichten Inhalte ins KI-Training einfließen. (Einige Quellen nennen den 27. Mai als Stichtag; empfohlen wird aber, spätestens am 26. Mai zu widersprechen, da Meta ab dem 27.05. mit dem Training beginnt.) Der Widerspruch muss pro Plattform/Konto erfolgen, Instagram und Facebook sind getrennt zu behandeln.
Richtig. Nutzerinnen können auch nach dem Stichtag jederzeit der Datenverwendung widersprechen. Allerdings verhindert ein später Widerspruch nur, dass künftig veröffentlichte Inhalte genutzt werden. Alles, was vor dem Widerspruch bereits ins Training eingespeist wurde, lässt sich nicht nachträglich aus den KI-Modellen entfernen. Datenschutz-Expertinnen betonen, dass einmal zum Training verwendete Daten technisch „nicht mehr aus dem Modell zurückholbar“ sind. Daher der dringende Rat, vorsorglich frühzeitig (vor dem 27. Mai) zu widersprechen.
Richtig. Statt jeder Nutzerin, um Erlaubnis zu fragen, beruft sich Meta auf Art. 6(1)(f) DSGVO, also ein „berechtigtes Interesse“ des Unternehmens, um diese Datenverarbeitung durchzuführen. Das heißt: Meta betrachtet das KI-Training als eigenes legitimes Interesse und räumt Nutzenden lediglich ein Widerspruchsrecht ein, anstatt vorher eine Zustimmung einzuholen. Dieses Vorgehen ist umstritten, da das europäische Datenschutzrecht bei berechtigtem Interesse einen Ausgleich mit den Grundrechten der Nutzer verlangt. Für personalisierte Werbung wurde Meta diese Begründung in der EU bereits gerichtlich untersagt; ob sie beim KI-Training zulässig ist, wird von Datenschützern bezweifelt.
Teils richtig, teils verkürzt. Aufsichtsbehörden in Irland und der EU haben Metas Pläne geprüft und Auflagen erteilt, aber letztlich nicht verboten. Die irische Datenschutzbehörde (DPC) verlangte z. B. eine längere Vorab-Infofrist, ein einfaches Widerspruchsformular und technische Schutzmaßnahmen (Daten-Anonymisierung, Filter). Meta setzte diese Vorgaben um, woraufhin der DPC kein Eilverbot aussprach. Verbraucherschützer in Deutschland zogen vor Gericht, um Metas KI-Training in letzter Minute zu stoppen, doch das Oberlandesgericht Köln lehnte den Eilantrag am 23. Mai 2025 ab. Damit darf Meta planmäßig am 27. Mai starten. Wichtig: „Zugestimmt“ heißt nicht, dass alle Bedenken ausgeräumt sind, die Behörden wollen die Umsetzung weiterhin eng überwachen.
Auch wenn du dem KI-Training bei Meta offiziell widersprichst, gibt es einen wichtigen Haken: Du bist damit nicht vollständig ausgeschlossen. Denn Meta weist in seiner Datenschutzrichtlinie ausdrücklich darauf hin, dass es trotz Widerspruch Informationen über dich verarbeiten kann, und zwar dann, wenn andere öffentlich über dich posten.
Was heißt das konkret?
Wenn jemand …
-ein öffentliches Foto postet, auf dem du zu sehen bist,
-dich in einem öffentlichen Facebook- oder Instagram-Kommentar erwähnt,
-ein Zitat von dir oder deinen Namen in einem Repost verwendet,
… dann kann Meta diese Inhalte trotz deines Widerspruchs für das KI-Training verwenden.
Warum ist das problematisch?
Du verlierst die Kontrolle darüber, ob und wie Informationen über dich in KI-Systeme gelangen, nicht, weil du selbst etwas gepostet hast, sondern weil andere es tun.
Deine Gesichtszüge, dein Name, dein Kontext können so Teil der Trainingsdaten werden, obwohl du genau das ausgeschlossen hast.
Es entsteht ein “Beifang-Effekt”: Deine Identität wird indirekt „miterfasst“, selbst wenn du bewusst verzichtest.
Beispiel:
Du hast dem KI-Training widersprochen.
Aber deine Freundin postet ein Selfie von euch beiden am Strand, öffentlich.
→ Meta erkennt: Zwei Personen, Sonne, Emotionen, Ortsdaten.
→ Dein Gesicht, deine Kleidung, deine Haltung könnten mitlernen, ohne, dass du zustimmen musst.
Oder du wirst in einem Kommentar erwähnt:
„@deinName hat was Kluges gesagt!“
→ Auch dieser Zusammenhang fließt ein, du bist Teil des Musters, auch ohne selbst aktiv gewesen zu sein.
–Widersprechen: Das ist und bleibt wichtig, es verhindert zumindest, dass deine eigenen öffentlichen Inhalte verwendet werden.
–Profil auf „privat“ stellen: Begrenze die Sichtbarkeit deiner Posts und Storys auf „Nur Freunde“ oder „Enge Freunde“.
–Fotos prüfen: Bitte Freunde, keine öffentlichen Bilder mit dir zu posten, oder markiere dich vorsorglich nicht.
–Aktiv Feedback geben: Datenschützer fordern Nachbesserungen. Du kannst dich an Verbraucherzentralen oder Datenschutzbehörden wenden.
Fazit: Dein Widerspruch ist wichtig, aber kein absoluter Schutzschild. Die Datenverarbeitung durch Meta betrifft nicht nur das, was du selbst tust, sondern auch das, was andere über dich veröffentlichen. Bewusstes Teilen, Datenschutz-Einstellungen und digitale Zurückhaltung sind die besten Ergänzungen zu deinem Einspruch.
Lesen Sie auch: Facebook-KI-Widerspruch per Status? Warum das nicht reicht

Hinweis: Stand zum Veröffentlichungsdatum.
Verwendete Bilder, Screenshots und Medien dienen ausschließlich der sachlichen Auseinandersetzung im Sinne des Zitatrechts (§ 51 UrhG).
Teile dieses Beitrags können KI-gestützt erstellt und redaktionell geprüft worden sein.
(Mehr zur Arbeitsweise)
